Rekayasa Konteks untuk Agen AI: Pelajaran dari Membangun Manus
2025/7/18 --Yichao 'Peak' Ji
Pada awal sekali proyek  Manus, tim saya dan saya menghadapi keputusan penting: haruskah kami melatih model agentic end-to-end menggunakan fondasi sumber terbuka, atau membangun agen di atas kemampuan
 pembelajaran dalam konteks dari model-model frontier?
Pada dekade pertama saya dalam NLP, kami tidak memiliki kemewahan pilihan itu. Di masa-masa lampau BERT (ya, sudah tujuh tahun), model harus di-fine-tune—dan dievaluasi—sebelum dapat ditransfer ke tugas baru. Proses itu sering memakan waktu berminggu-minggu per iterasi, meskipun model-model tersebut sangat kecil dibandingkan dengan LLM saat ini. Untuk aplikasi yang bergerak cepat, terutama pra-PMF, siklus umpan balik yang lambat seperti itu adalah penghalang besar. Itu adalah pelajaran pahit dari startup terakhir saya, di mana saya melatih model dari awal untuk
 ekstraksi informasi terbuka dan pencarian semantik. Kemudian muncul GPT-3 dan Flan-T5, dan model buatan saya menjadi tidak relevan dalam semalam. Ironisnya, model-model yang sama itu menandai awal dari pembelajaran dalam konteks—dan jalur baru ke depan.
Pelajaran berharga itu membuat pilihan menjadi jelas: Manus akan bertaruh pada rekayasa konteks. Ini memungkinkan kami mengirimkan perbaikan dalam hitungan jam, bukan minggu, dan menjaga produk kami tetap ortogonal terhadap model yang mendasarinya: Jika kemajuan model adalah air pasang yang naik, kami ingin Manus menjadi perahunya, bukan pilar yang menempel di dasar laut.
Meski begitu, rekayasa konteks ternyata sama sekali tidak mudah. Ini adalah ilmu eksperimental—dan kami telah membangun ulang kerangka agen kami empat kali, setiap kali setelah menemukan cara yang lebih baik untuk membentuk konteks. Kami dengan penuh kasih menyebut proses manual pencarian arsitektur, penyesuaian prompt, dan perkiraan empiris ini sebagai "Stochastic Graduate Descent". Ini tidak elegan, tapi berhasil.
Postingan ini membagikan optima lokal yang kami capai melalui "SGD" kami sendiri. Jika Anda membangun agen AI Anda sendiri, saya harap prinsip-prinsip ini membantu Anda konvergen lebih cepat.
Desain Sekitar KV-Cache
Jika saya harus memilih hanya satu metrik, saya berpendapat bahwa KV-cache hit rate adalah metrik tunggal yang paling penting untuk agen AI tahap produksi. Ini secara langsung mempengaruhi latensi dan biaya. Untuk memahami alasannya, mari kita lihat bagaimana agen tipikal beroperasi:
Setelah menerima input pengguna, agen melanjutkan melalui rangkaian penggunaan alat untuk menyelesaikan tugas. Dalam setiap iterasi, model memilih sebuah aksi dari ruang aksi yang telah ditentukan berdasarkan konteks saat ini. Aksi tersebut kemudian dijalankan di lingkungan (misalnya, sandbox mesin virtual Manus) untuk menghasilkan sebuah observasi. Aksi dan observasi ditambahkan ke konteks, membentuk input untuk iterasi berikutnya. Loop ini berlanjut hingga tugas selesai.
Seperti yang dapat Anda bayangkan, konteks bertambah dengan setiap langkah, sementara output—biasanya berupa panggilan fungsi terstruktur—tetap relatif singkat. Ini membuat rasio antara prefilling dan decoding sangat tidak seimbang pada agen dibandingkan dengan chatbot. Di Manus, misalnya, rasio rata-rata token input-ke-output adalah sekitar 100:1.
Untungnya, konteks dengan awalan yang identik dapat memanfaatkan  KV-cache, yang secara drastis mengurangi time-to-first-token (TTFT) dan biaya inferensi—baik Anda menggunakan model yang dihosting sendiri atau memanggil API inferensi. Dan kita tidak berbicara tentang penghematan kecil: dengan Claude Sonnet, misalnya, token input yang di-cache biayanya 0,30 USD/MTok, sementara yang tidak di-cache biayanya 3 USD/MTok—perbedaan 10 kali lipat.
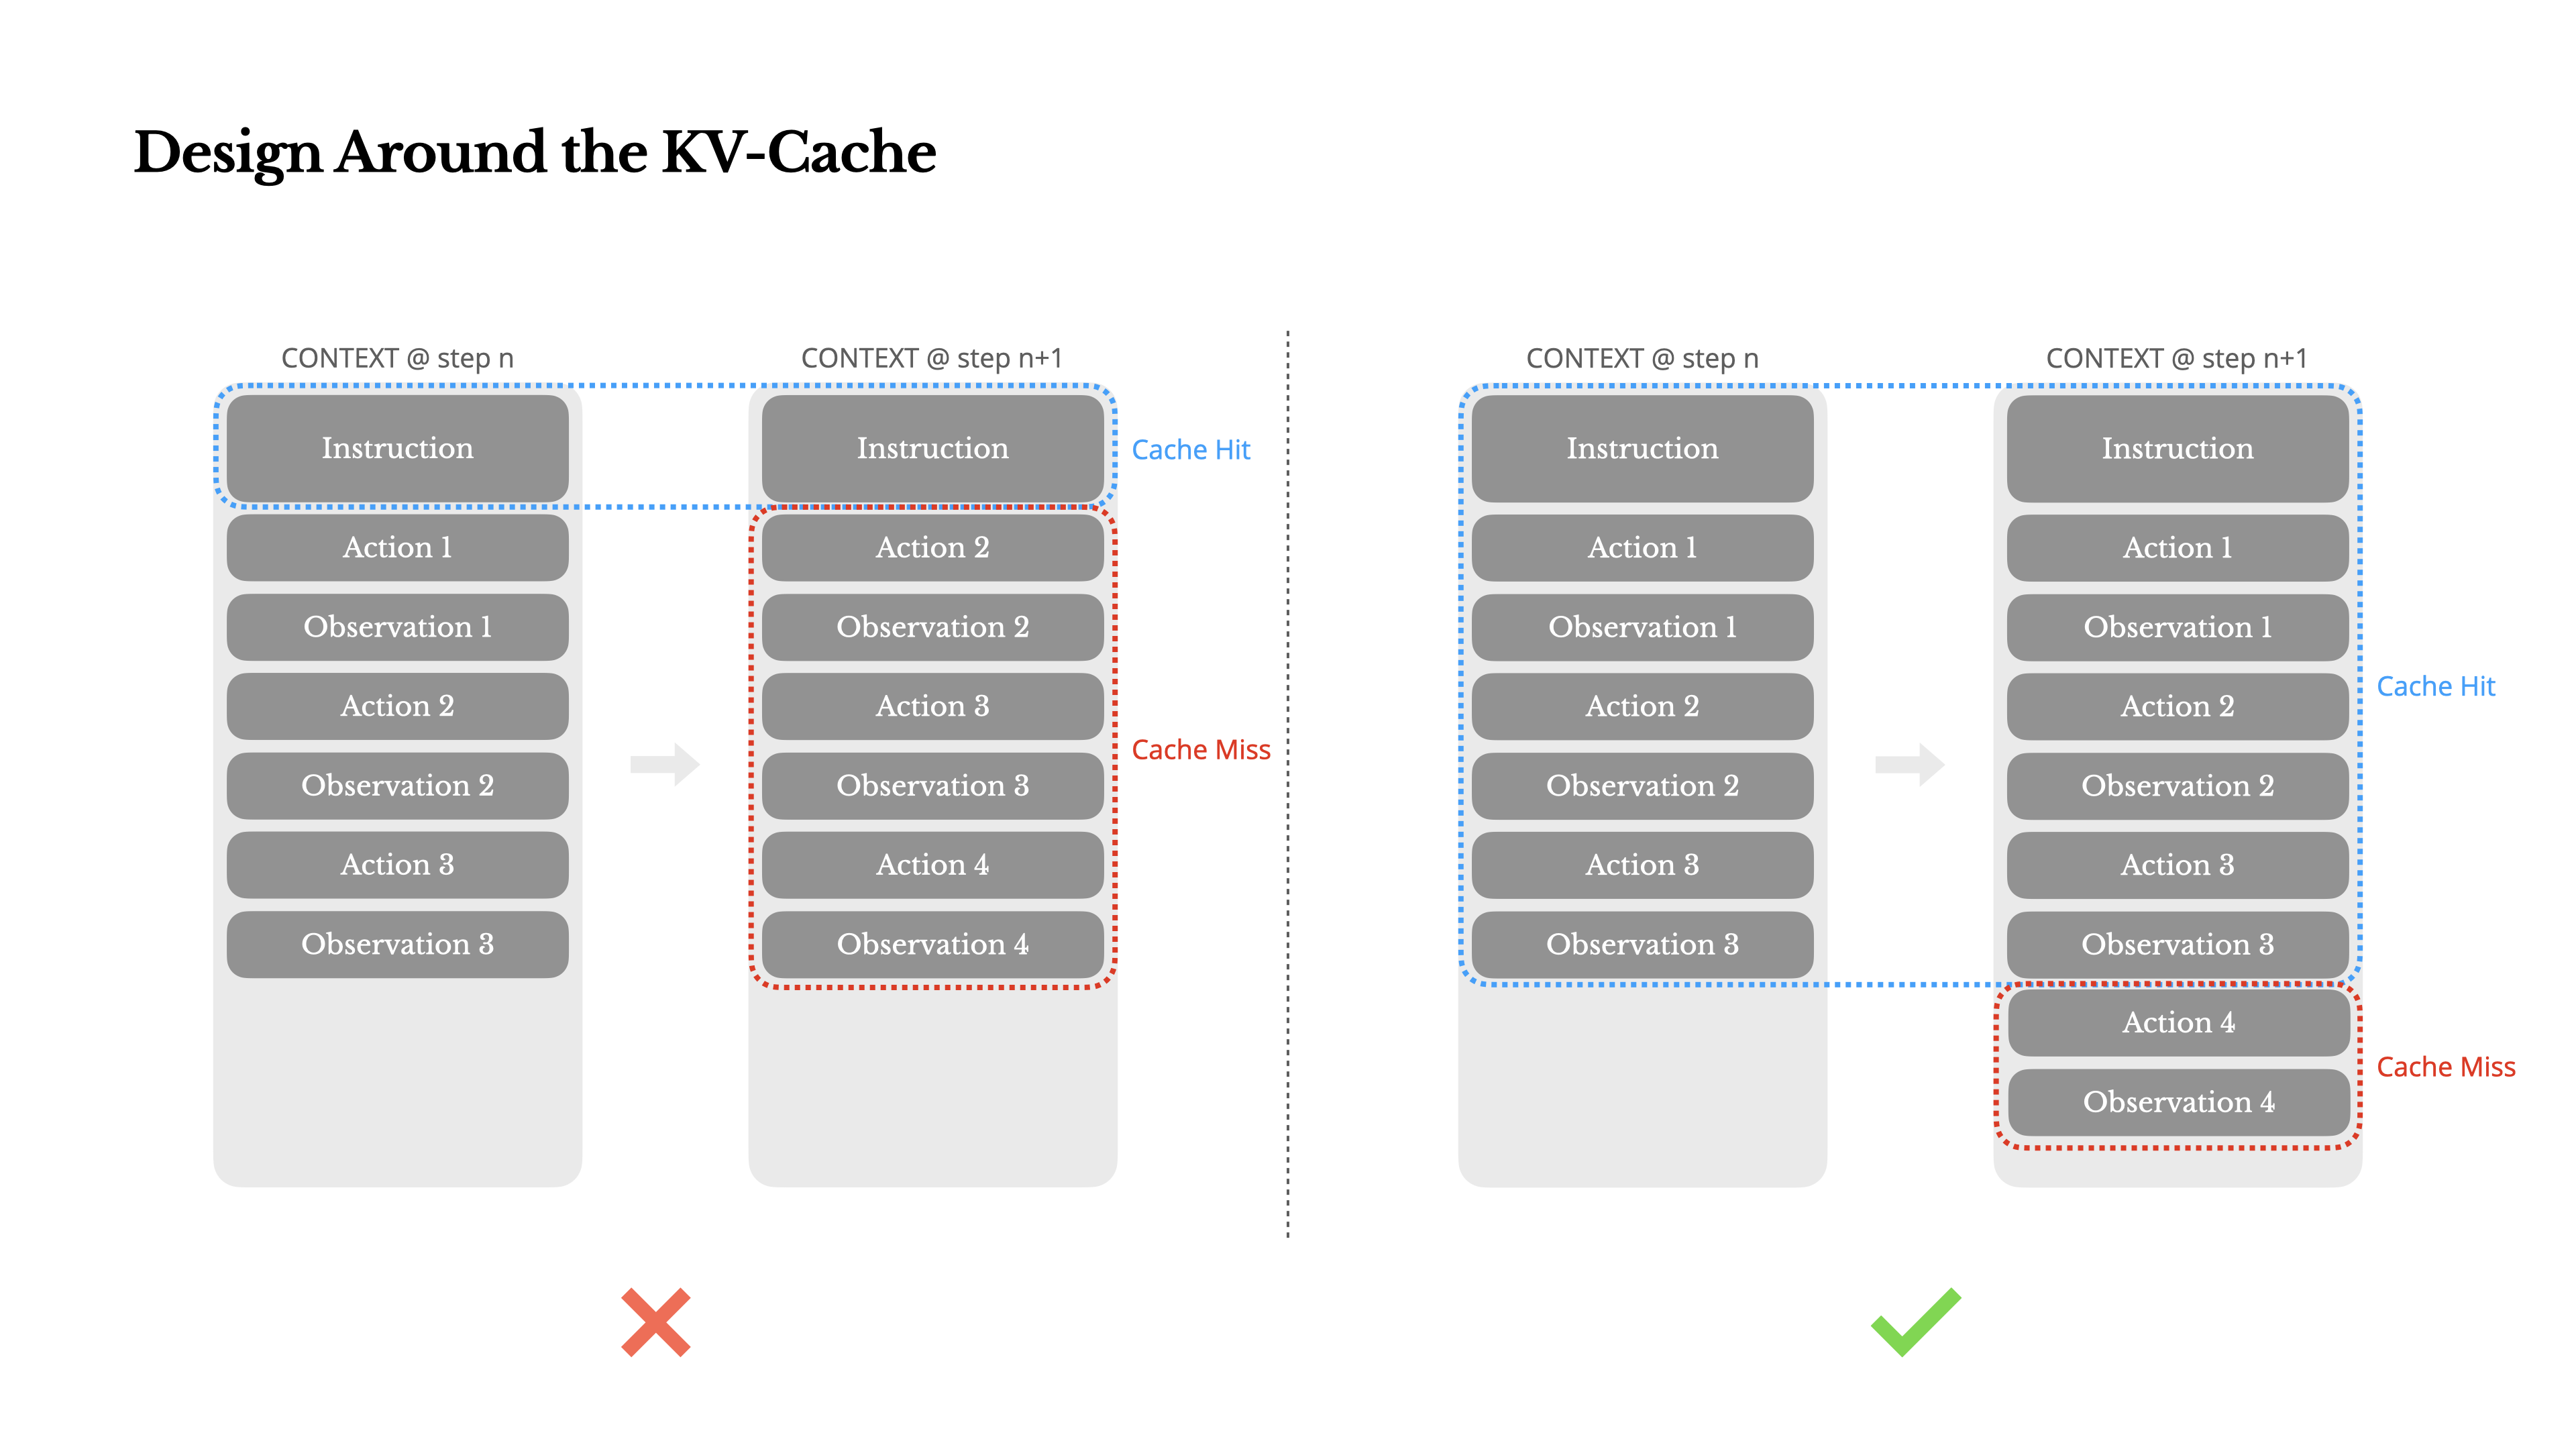
1.Jaga agar awalan prompt Anda stabil. Karena sifat autoregressive dari LLM, bahkan perbedaan satu token pun dapat menginvalidasi cache dari token tersebut dan seterusnya. Kesalahan umum adalah menyertakan stempel waktu—terutama yang presisi hingga detik—di awal prompt sistem. Memang, ini memungkinkan model memberi tahu Anda waktu saat ini, tetapi juga menghancurkan tingkat hit cache Anda.
2.Buat konteks Anda hanya dapat ditambahkan. Hindari memodifikasi tindakan atau pengamatan sebelumnya. Pastikan serialisasi Anda deterministik. Banyak bahasa pemrograman dan pustaka tidak menjamin urutan kunci yang stabil saat melakukan serialisasi objek JSON, yang dapat diam-diam merusak cache.
3.Tandai breakpoint cache secara eksplisit saat diperlukan. Beberapa penyedia model atau framework inferensi tidak mendukung caching prefiks inkremental otomatis, dan sebagai gantinya memerlukan penyisipan breakpoint cache secara manual dalam konteks. Saat menetapkan ini, perhitungkan potensi kedaluwarsa cache dan minimal, pastikan breakpoint mencakup akhir dari system prompt.
Selain itu, jika Anda melakukan self-hosting model menggunakan framework seperti  vLLM, pastikan
 prefix/prompt caching diaktifkan, dan Anda menggunakan teknik seperti session ID untuk mengarahkan permintaan secara konsisten di seluruh worker terdistribusi.
Masking, Bukan Menghapus
Ketika agen Anda mengambil lebih banyak kemampuan, ruang tindakannya secara alami menjadi lebih kompleks—dengan kata sederhana, jumlah alat meledak. Popularitas terbaru dari  MCP hanya menambah bahan bakar ke api. Jika Anda mengizinkan alat yang dapat dikonfigurasi pengguna, percayalah: seseorang pasti akan mencolokkan ratusan alat misterius ke dalam ruang tindakan yang telah Anda kurasi dengan hati-hati. Akibatnya, model lebih mungkin memilih tindakan yang salah atau mengambil jalur yang tidak efisien. Singkatnya, agen Anda yang dipersenjatai berat menjadi lebih bodoh.
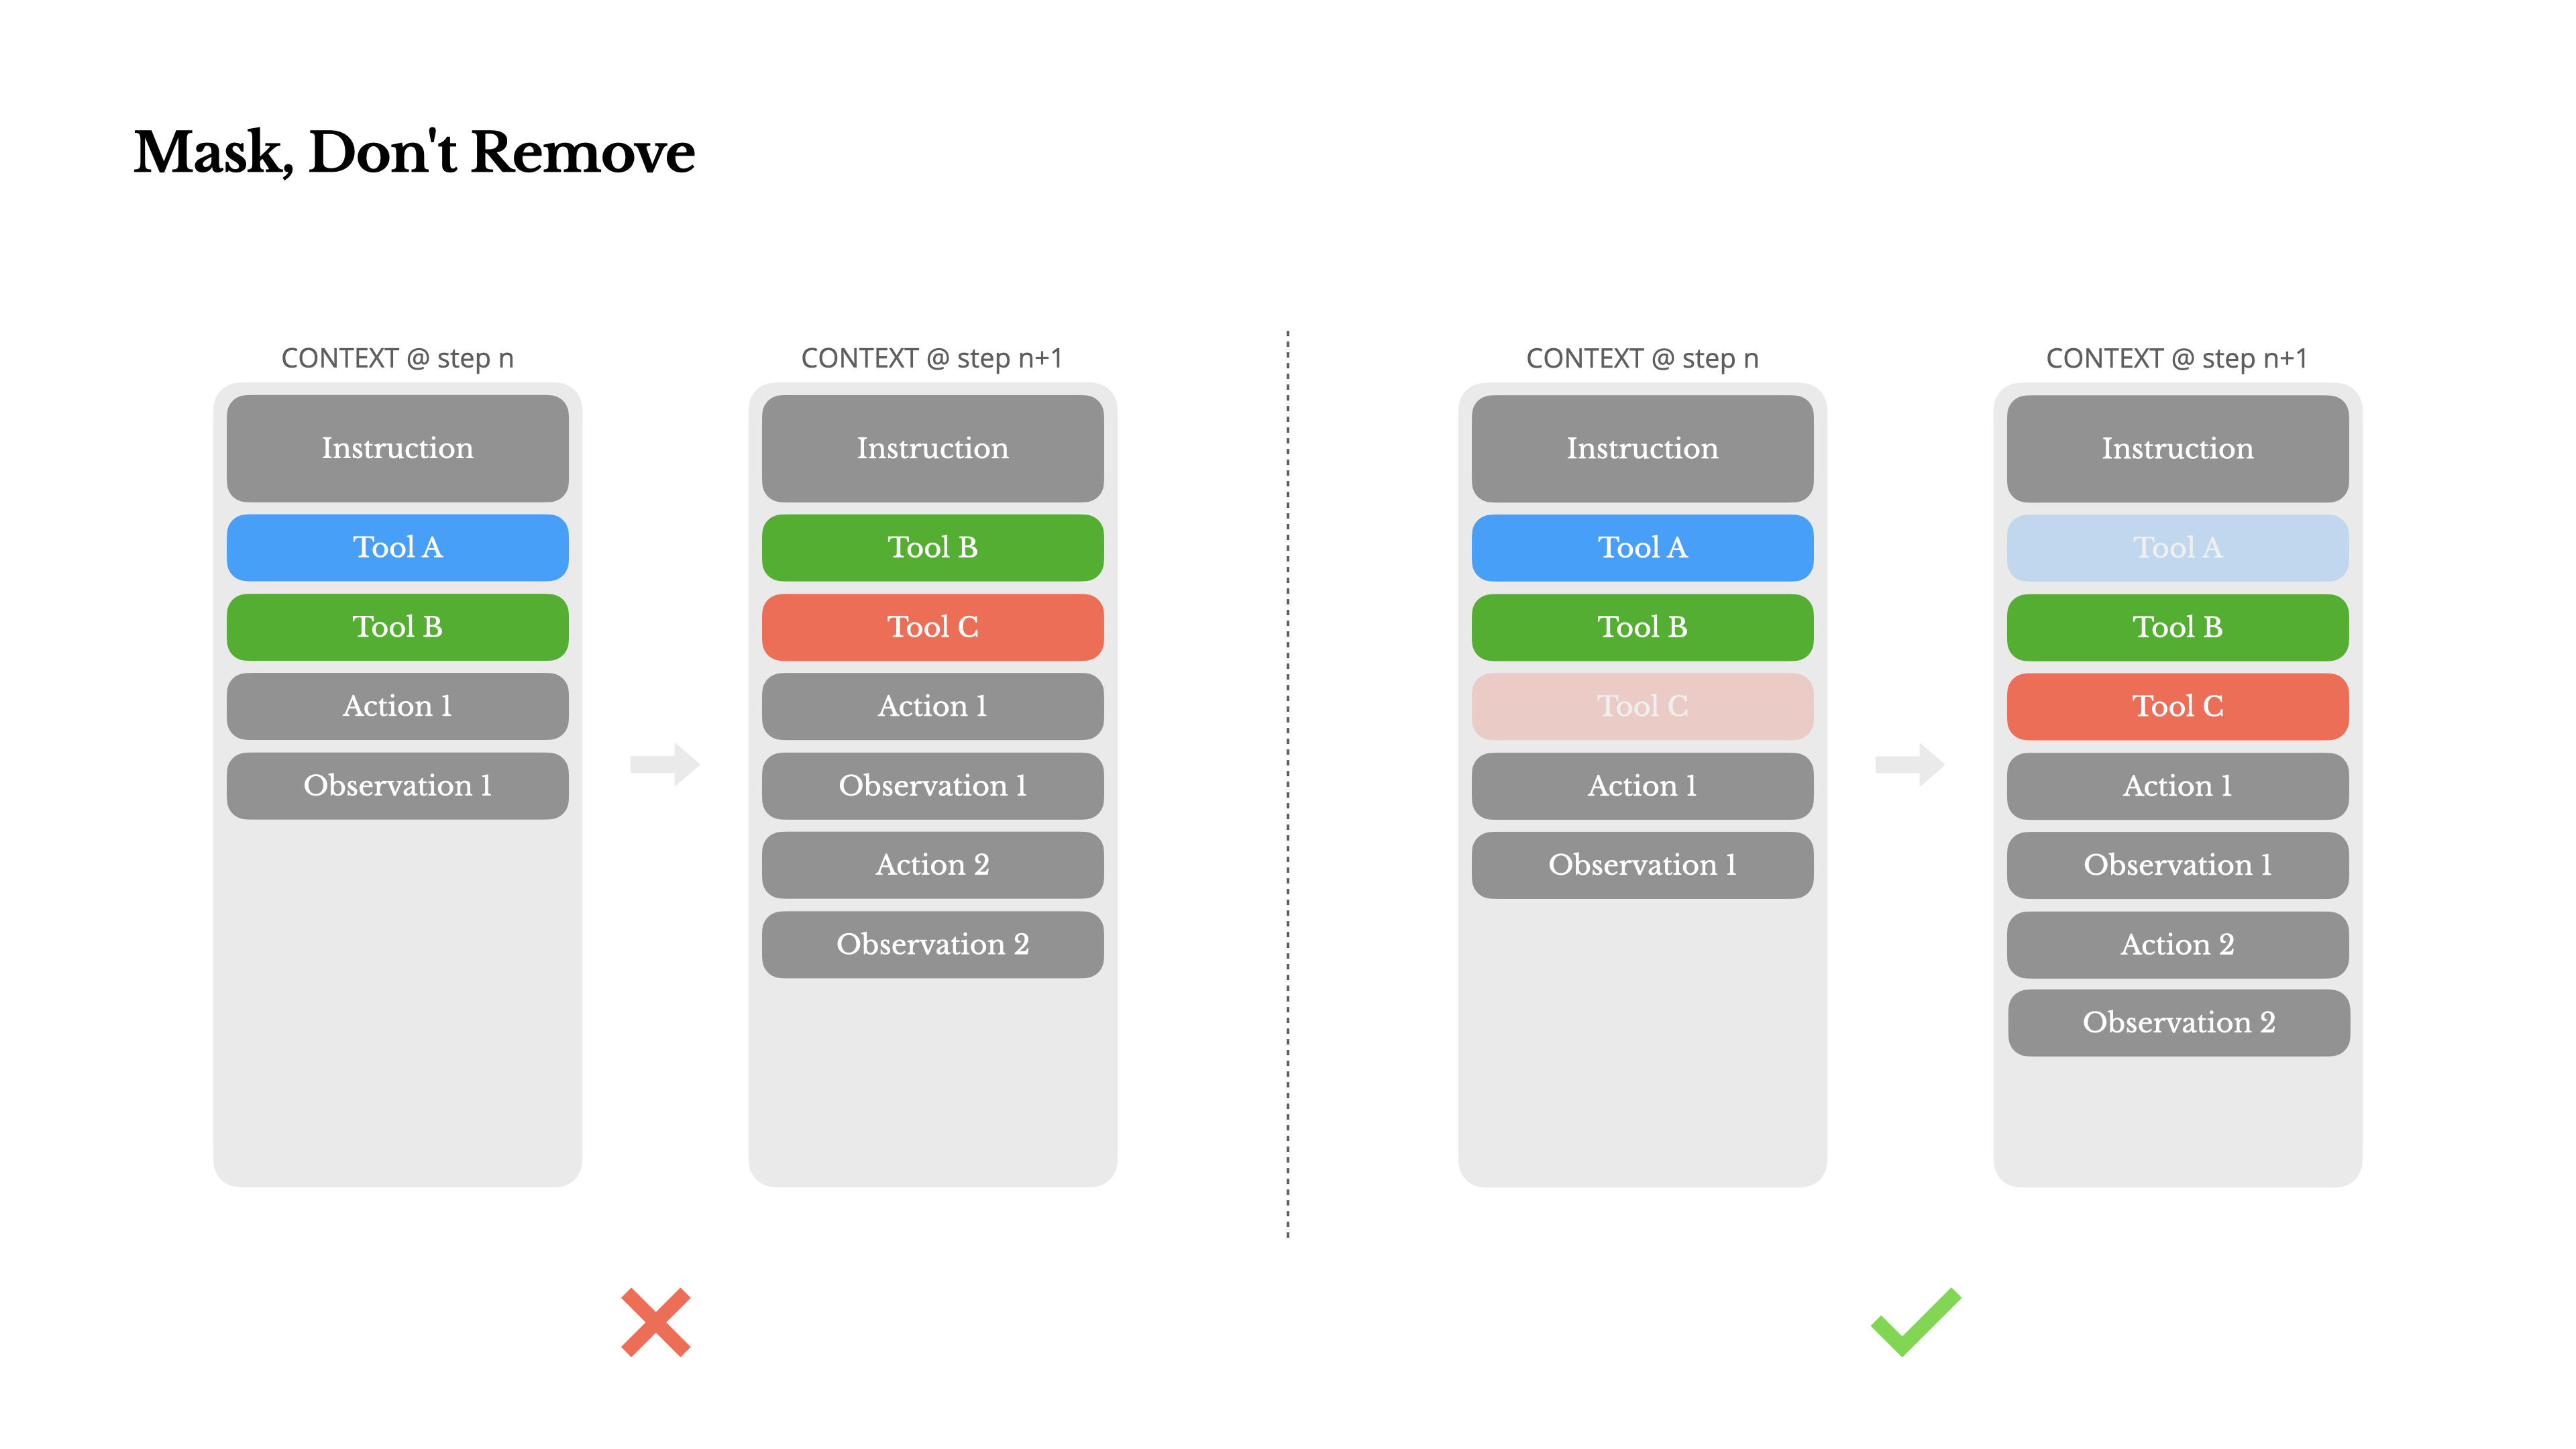
Reaksi alami adalah merancang ruang tindakan dinamis—mungkin memuat alat sesuai permintaan menggunakan sesuatu seperti RAG. Kami juga mencoba itu di Manus. Tetapi eksperimen kami menunjukkan aturan yang jelas: kecuali benar-benar diperlukan, hindari menambahkan atau menghapus alat secara dinamis di tengah iterasi. Ada dua alasan utama untuk ini:
1.Dalam kebanyakan LLM, definisi alat berada di dekat bagian depan konteks setelah serialisasi, biasanya sebelum atau sesudah prompt sistem. Jadi setiap perubahan akan membatalkan KV-cache untuk semua tindakan dan observasi berikutnya.
2.Ketika tindakan dan observasi sebelumnya masih merujuk pada alat yang tidak lagi didefinisikan dalam konteks saat ini, model menjadi bingung. Tanpa  constrained decoding, ini sering menyebabkan pelanggaran skema atau tindakan yang dihalusinasi.
Untuk menyelesaikan masalah ini sambil tetap meningkatkan pemilihan tindakan, Manus menggunakan state machine yang sadar konteks untuk mengelola ketersediaan alat. Daripada menghapus alat, ia menutupi logit token selama decoding untuk mencegah (atau memaksakan) pemilihan tindakan tertentu berdasarkan konteks saat ini.
•Auto – Model dapat memilih untuk memanggil fungsi atau tidak. Diimplementasikan dengan hanya mengisi awalan balasan: <|im_start|>assistant
•Required – Model harus memanggil fungsi, tetapi pilihannya tidak dibatasi. Diimplementasikan dengan mengisi hingga token pemanggilan alat: <|im_start|>assistant<tool_call>
•Specified – Model harus memanggil fungsi dari subset tertentu. Diimplementasikan dengan mengisi hingga awal nama fungsi: <|im_start|>assistant<tool_call>{"name": "browser_
Dengan ini, kita membatasi pemilihan tindakan dengan melakukan masking langsung pada logit token. Misalnya, ketika pengguna memberikan input baru, Manus harus langsung merespons alih-alih mengambil tindakan. Kami juga telah sengaja merancang nama-nama tindakan dengan awalan yang konsisten—misalnya, semua alat terkait browser dimulai dengan browser_, dan alat command-line dengan shell_. Ini memungkinkan kita untuk dengan mudah memastikan bahwa agen hanya memilih dari kelompok alat tertentu pada keadaan tertentu tanpa menggunakan stateful logits processors.
Desain-desain ini membantu memastikan bahwa loop agen Manus tetap stabil—bahkan dalam arsitektur yang dikendalikan oleh model.
Menggunakan Sistem File sebagai Konteks
LLM frontier modern kini menawarkan jendela konteks sebesar 128K token atau lebih. Namun dalam skenario agentic dunia nyata, itu seringkali tidak cukup, dan terkadang bahkan menjadi kendala. Ada tiga masalah umum:
1.Observasi bisa sangat besar, terutama ketika agen berinteraksi dengan data tidak terstruktur seperti halaman web atau PDF. Sangat mudah untuk melampaui batas konteks.
2.Performa model cenderung menurun di luar panjang konteks tertentu, meskipun jendela secara teknis mendukungnya.
3.Input panjang itu mahal, bahkan dengan caching prefiks. Anda tetap membayar untuk mentransmisikan dan mengisi awal setiap token.
Untuk mengatasi hal ini, banyak sistem agen mengimplementasikan strategi pemotongan atau kompresi konteks. Tetapi kompresi yang terlalu agresif pasti menyebabkan hilangnya informasi. Masalahnya fundamental: agen, secara alami, harus memprediksi tindakan berikutnya berdasarkan semua keadaan sebelumnya—dan Anda tidak dapat secara andal memprediksi observasi mana yang mungkin menjadi kritis sepuluh langkah kemudian. Dari sudut pandang logis, kompresi yang tidak dapat dibalik membawa risiko.
Itulah mengapa kami memperlakukan sistem file sebagai konteks utama di Manus: tidak terbatas ukurannya, persisten secara alami, dan dapat dioperasikan langsung oleh agen itu sendiri. Model belajar untuk menulis ke dan membaca dari file sesuai kebutuhan—menggunakan sistem file tidak hanya sebagai penyimpanan, tetapi sebagai memori eksternal yang terstruktur.
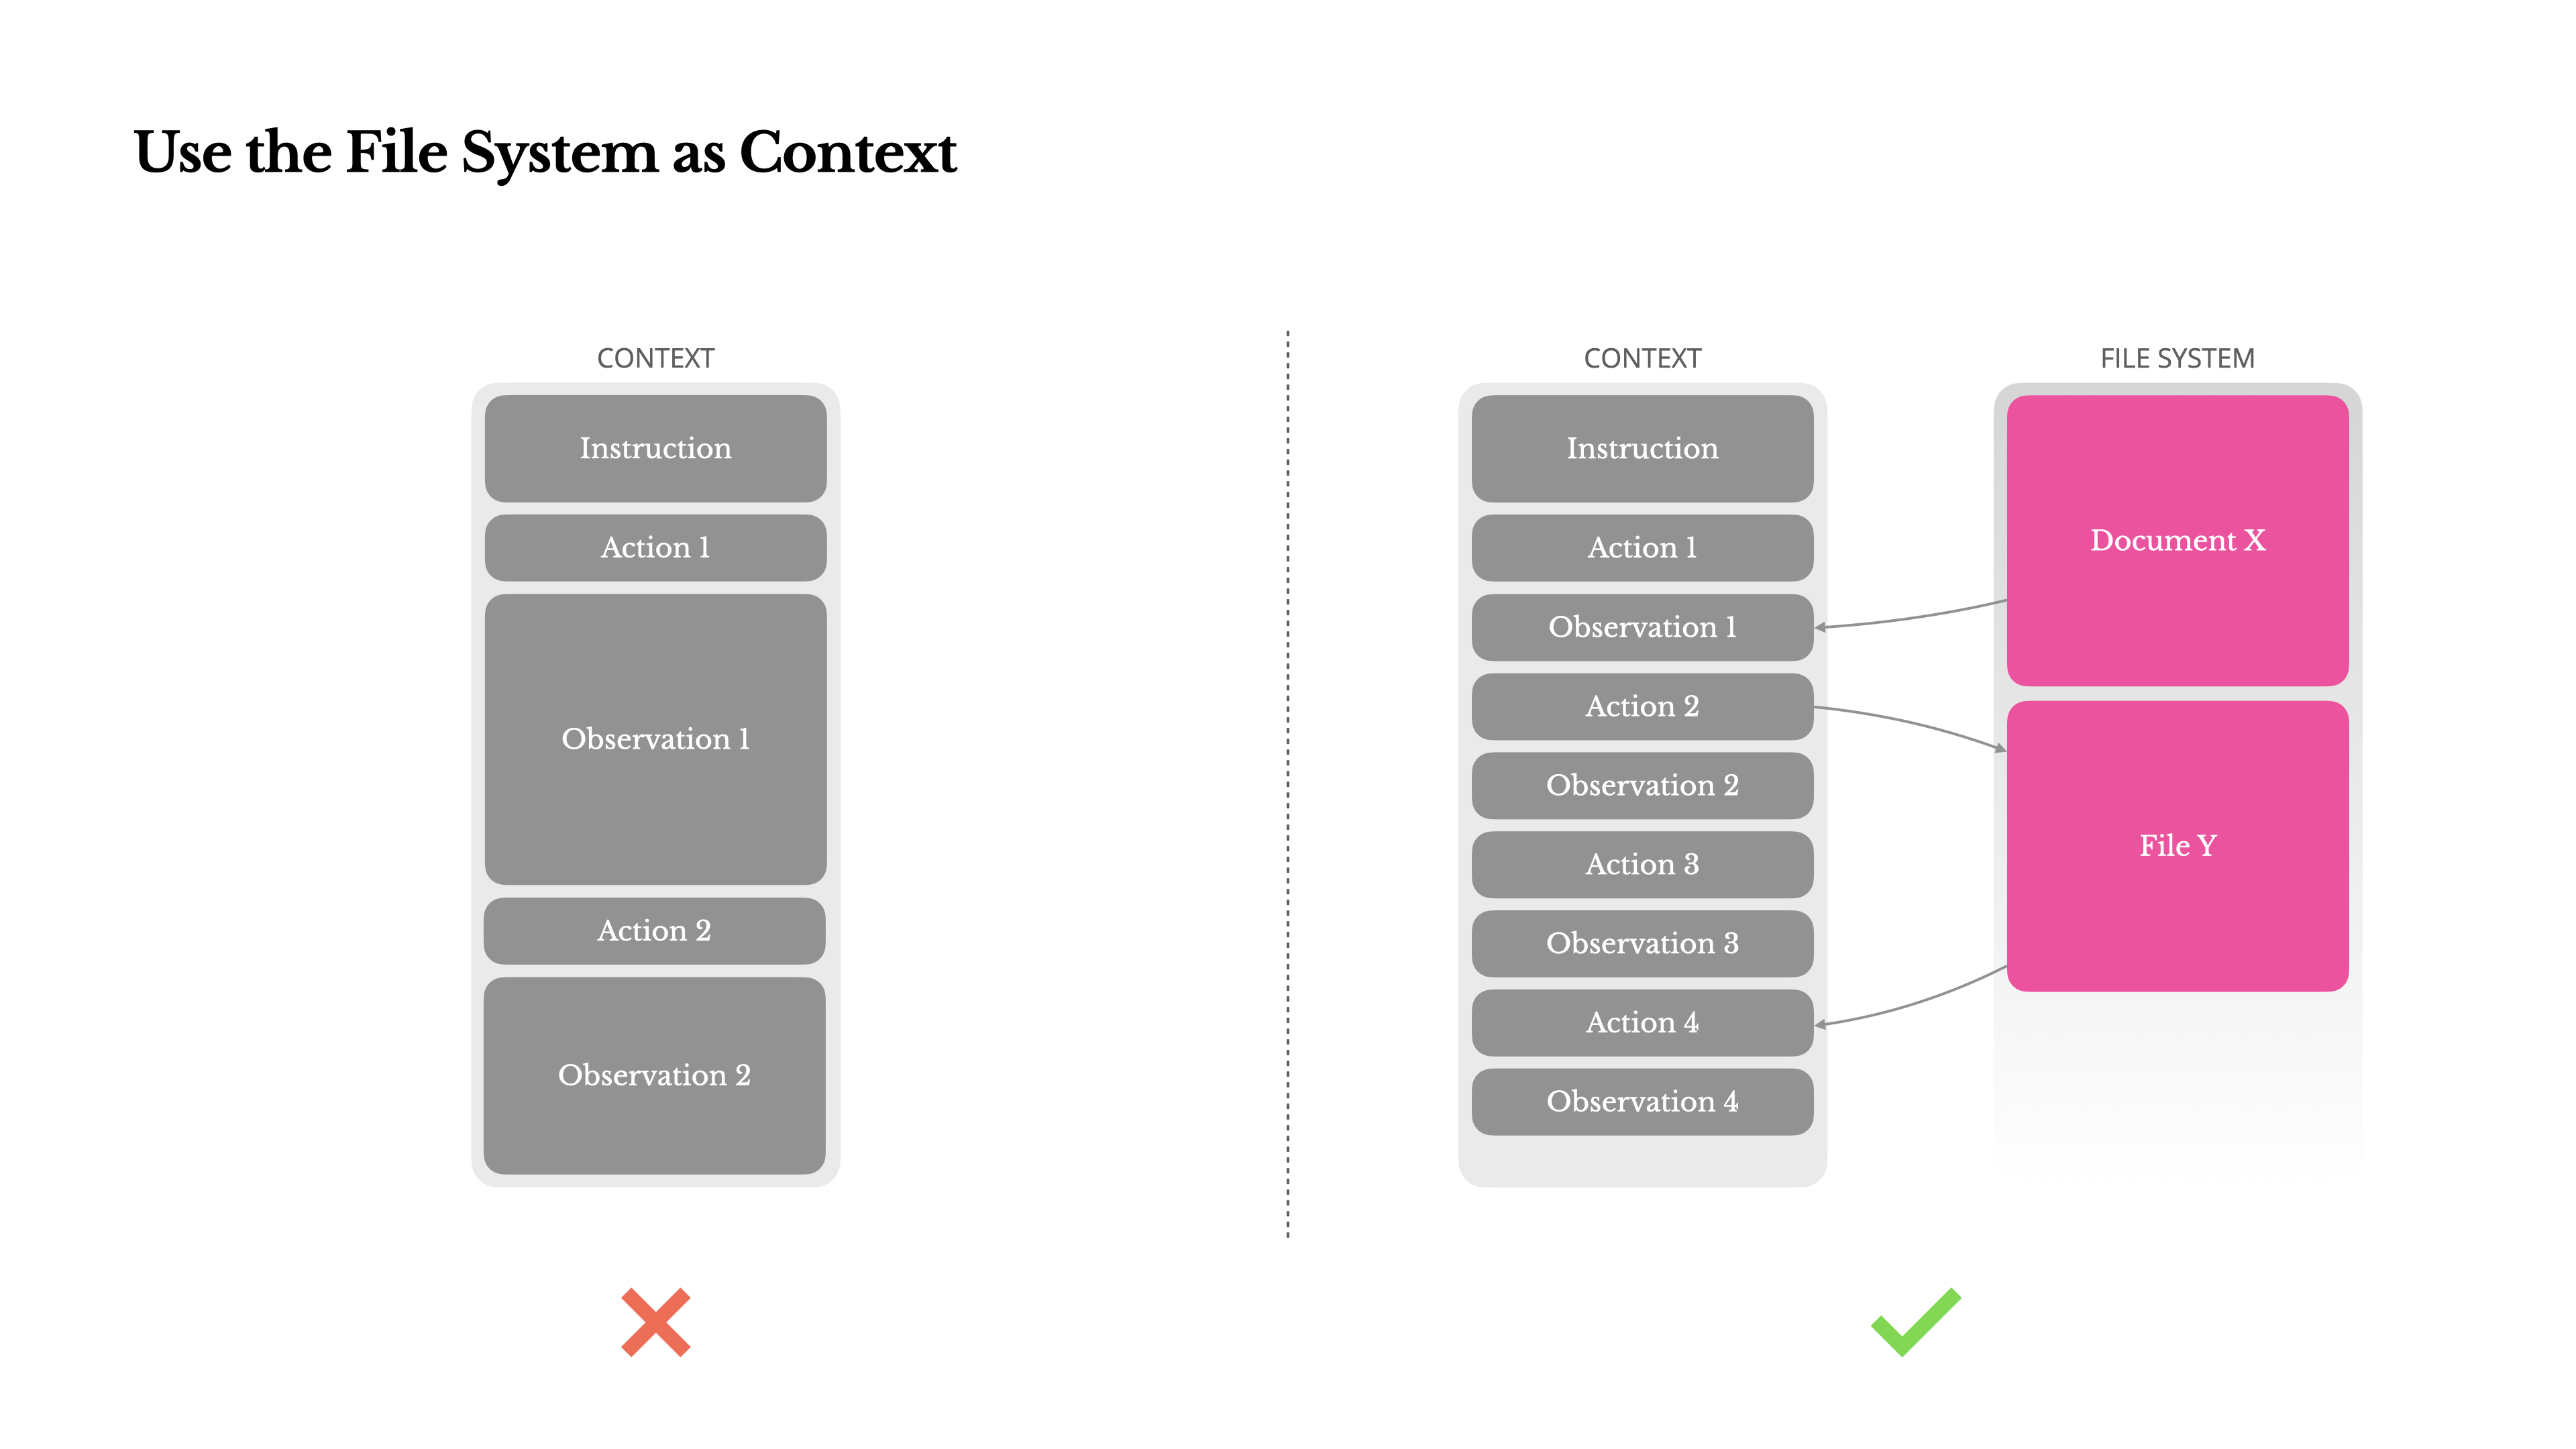
Strategi kompresi kami selalu dirancang agar dapat dipulihkan. Misalnya, konten halaman web dapat dihapus dari konteks selama URL-nya dipertahankan, dan isi dokumen dapat dihilangkan jika jalurnya tetap tersedia di sandbox. Ini memungkinkan Manus untuk memperkecil panjang konteks tanpa kehilangan informasi secara permanen.
Selama mengembangkan fitur ini, saya membayangkan apa yang diperlukan agar State Space Model (SSM) dapat bekerja secara efektif dalam pengaturan agentik. Tidak seperti Transformer, SSM tidak memiliki perhatian penuh dan kesulitan dengan ketergantungan mundur jarak jauh. Tetapi jika mereka dapat menguasai memori berbasis file—mengeksternalisasi keadaan jangka panjang alih-alih menyimpannya dalam konteks—maka kecepatan dan efisiensi mereka mungkin dapat membuka kelas agen baru. SSM Agentik bisa menjadi penerus sesungguhnya dari Neural Turing Machines.
Memanipulasi Perhatian Melalui Pengulangan
Jika Anda telah bekerja dengan Manus, Anda mungkin telah memperhatikan sesuatu yang menarik: ketika menangani tugas kompleks, ia cenderung membuat file todo.md—dan memperbaruinya langkah demi langkah seiring berjalannya tugas, mencentang item yang telah selesai.
Itu bukan hanya perilaku lucu—itu adalah mekanisme yang disengaja untuk memanipulasi perhatian.
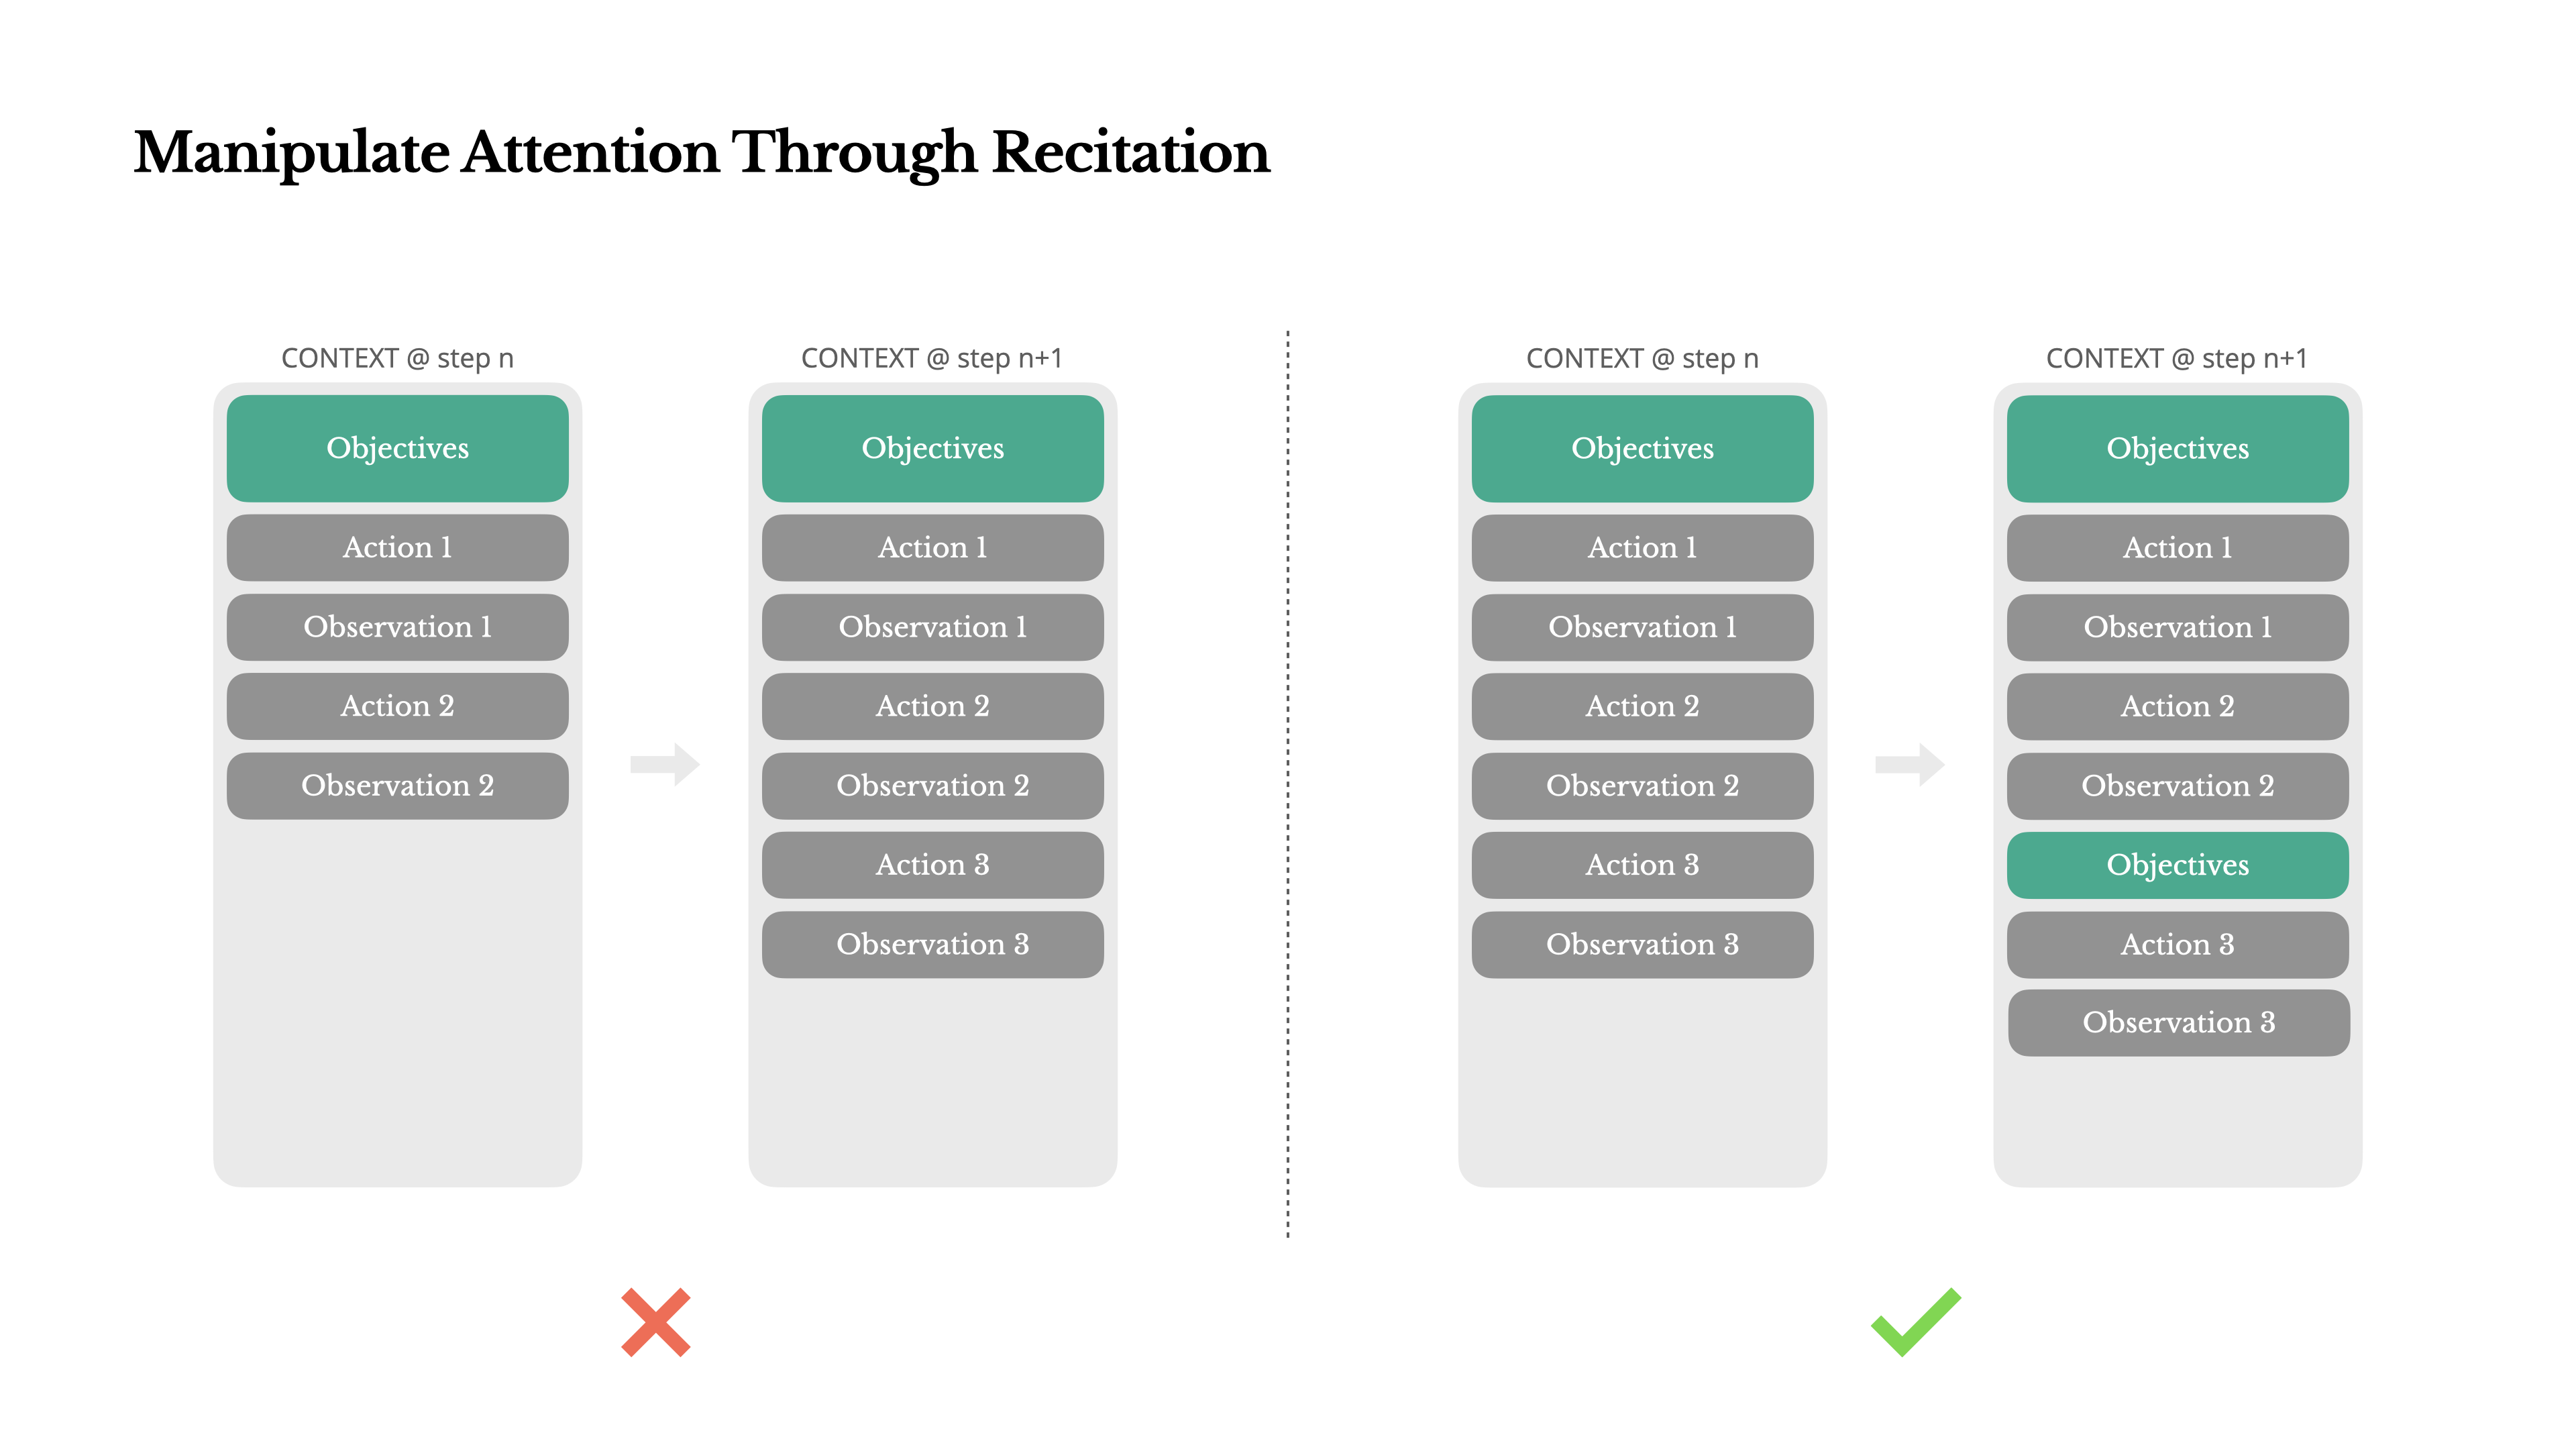
Tugas tipikal di Manus membutuhkan sekitar 50 panggilan alat secara rata-rata. Ini adalah loop yang panjang—dan karena Manus mengandalkan LLM untuk pengambilan keputusan, sistem ini rentan terhadap penyimpangan topik atau melupakan tujuan sebelumnya, terutama dalam konteks yang panjang atau tugas-tugas rumit.
Dengan terus menulis ulang daftar tugas, Manus mengulang tujuannya di akhir konteks. Ini mendorong rencana global ke dalam rentang perhatian terkini model, menghindari masalah "lost-in-the-middle" dan mengurangi ketidakselarasan tujuan. Pada dasarnya, ini menggunakan bahasa alami untuk mengarahkan fokusnya sendiri pada tujuan tugas—tanpa memerlukan perubahan arsitektur khusus.
Keep the Wrong Stuff In
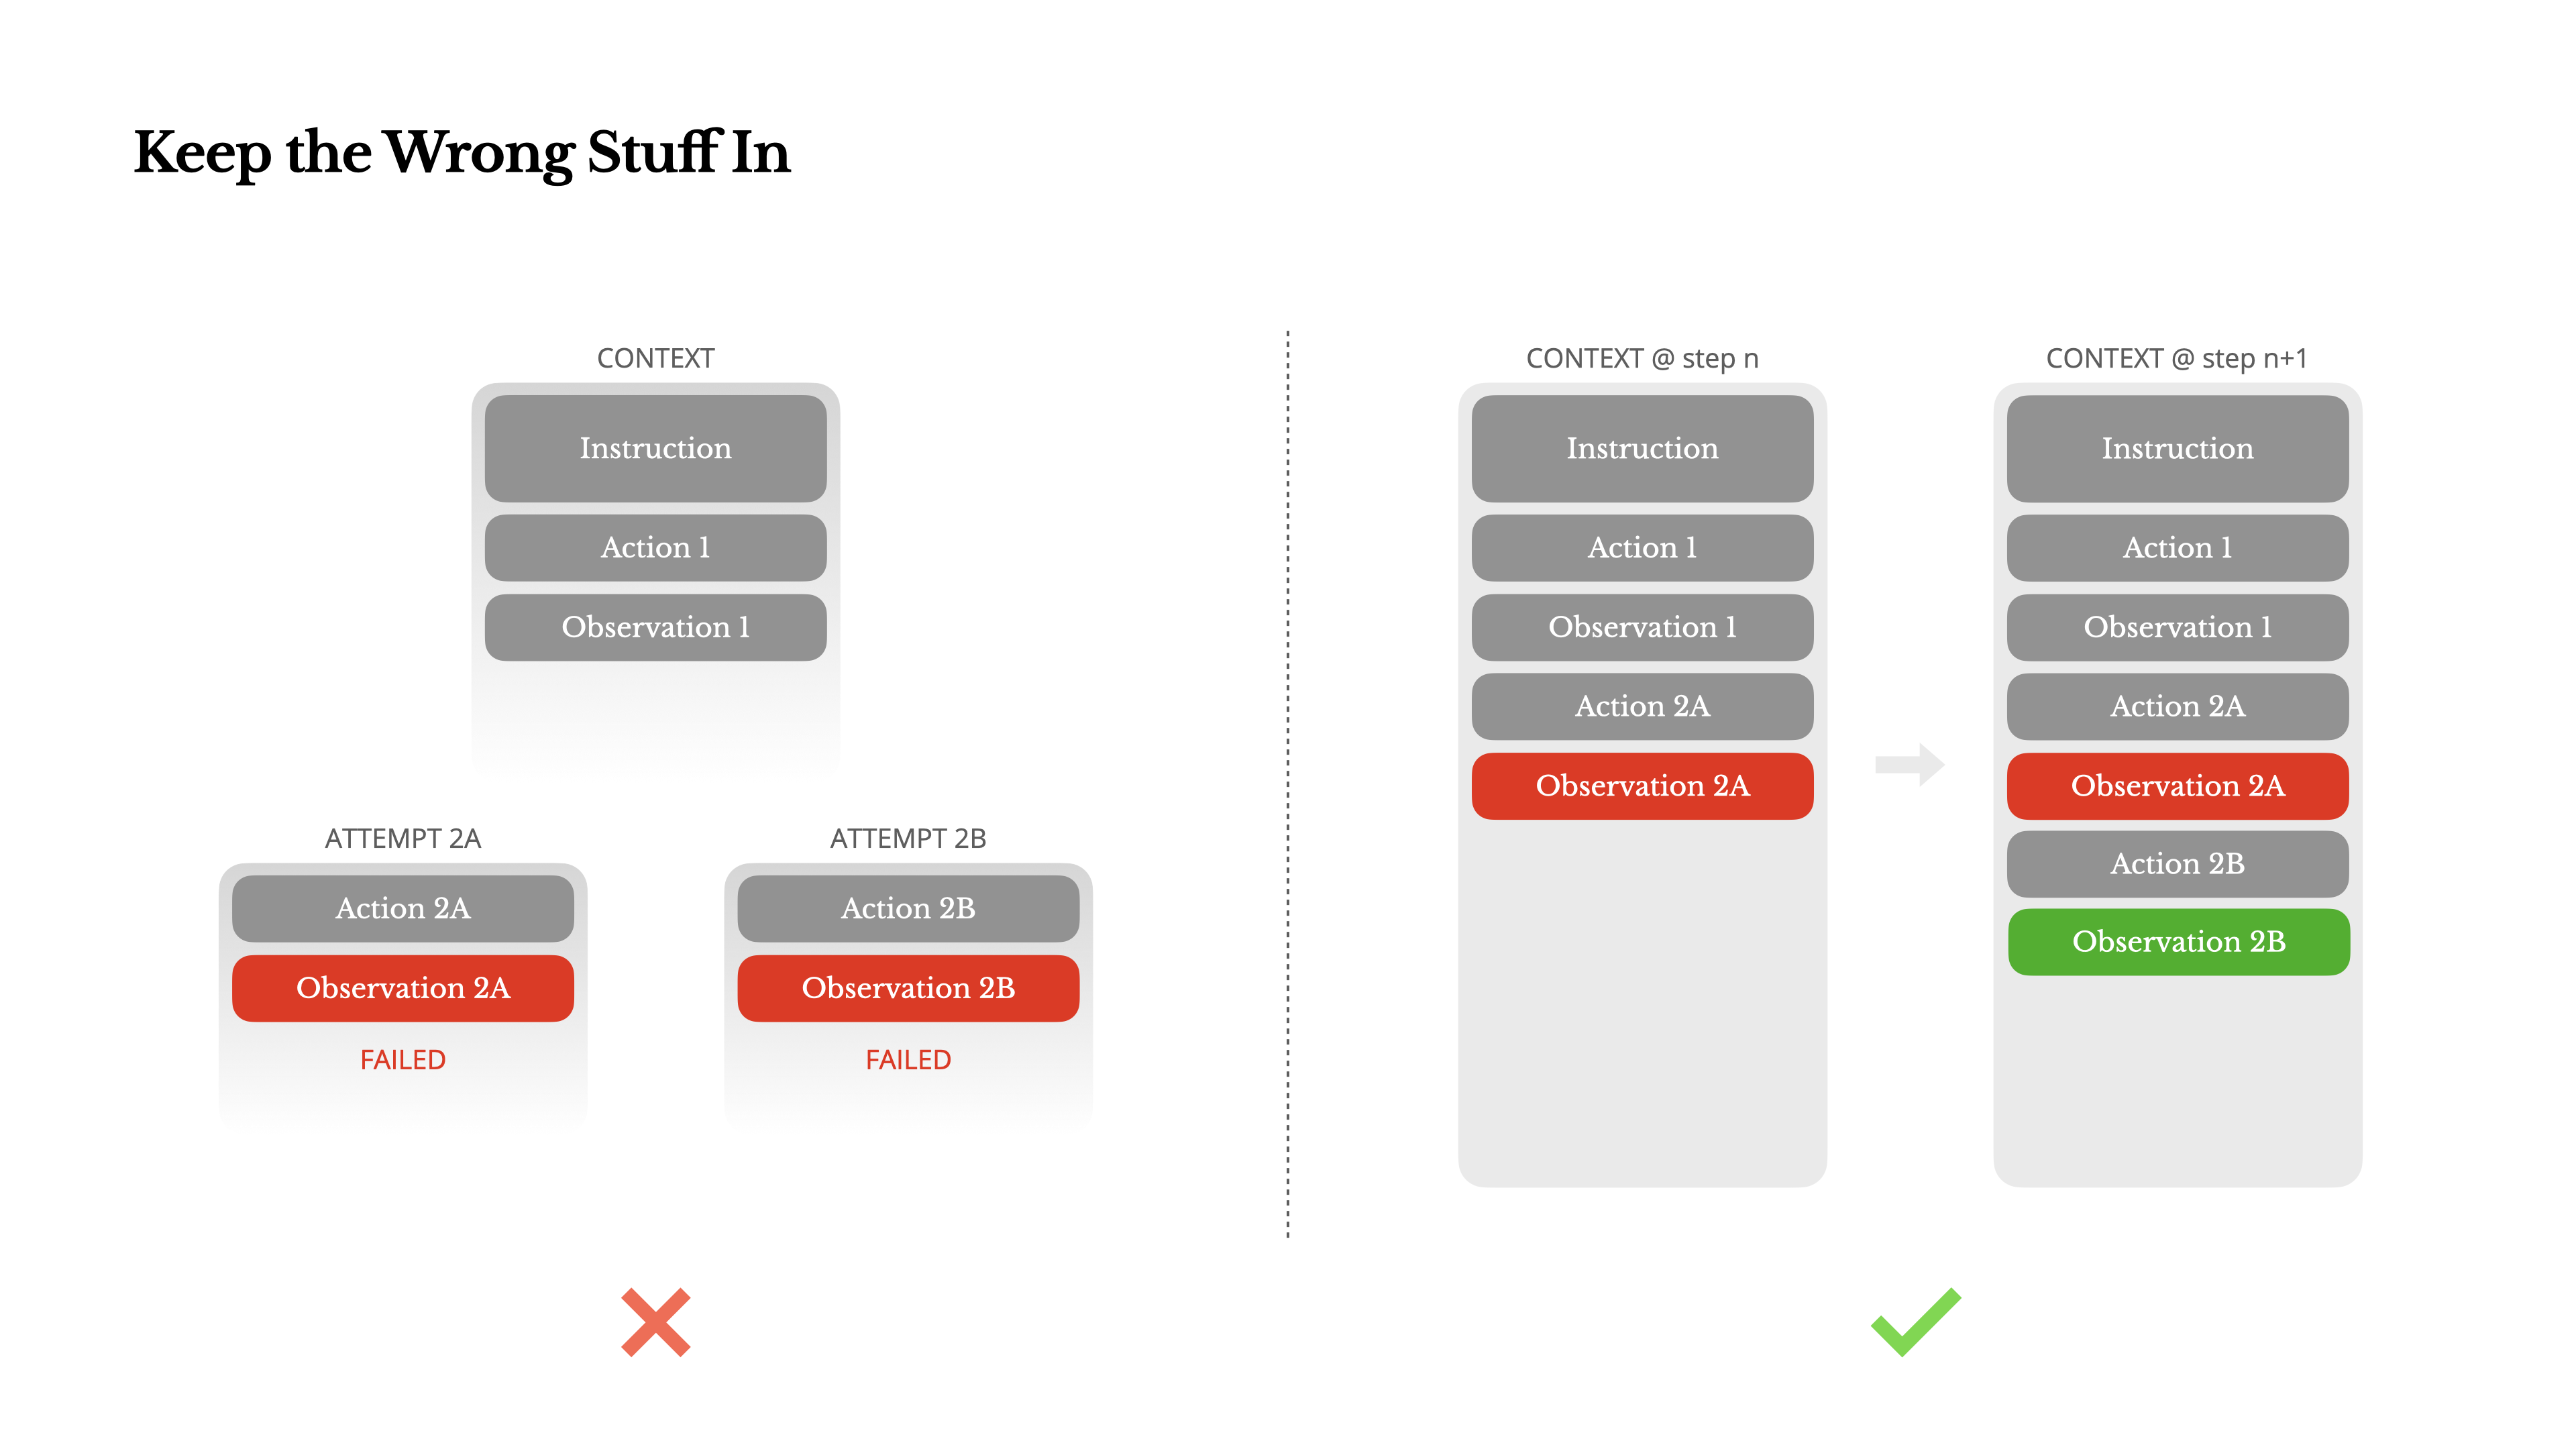
Agen membuat kesalahan. Itu bukan bug—itu realitas. Model bahasa berhalusinasi, lingkungan mengembalikan kesalahan, alat eksternal tidak berfungsi dengan baik, dan kasus-kasus tak terduga muncul sepanjang waktu. Dalam tugas multi-langkah, kegagalan bukanlah pengecualian; itu adalah bagian dari siklus.
Namun, dorongan umum adalah menyembunyikan kesalahan ini: membersihkan jejak, mencoba ulang tindakan, atau mengatur ulang keadaan model dan menyerahkannya pada "temperature" yang ajaib. Itu terasa lebih aman, lebih terkendali. Tetapi itu datang dengan biaya: Menghapus kegagalan menghilangkan bukti. Dan tanpa bukti, model tidak dapat beradaptasi.
Jangan Terjebak Few-Shot
Ini bisa berbahaya dalam tugas-tugas yang melibatkan keputusan atau tindakan berulang. Misalnya, ketika menggunakan Manus untuk membantu meninjau 20 resume sekaligus, agen sering terjebak dalam ritme—mengulangi tindakan serupa hanya karena itulah yang dilihatnya dalam konteks. Hal ini menyebabkan penyimpangan, overgeneralisasi, atau terkadang halusinasi.
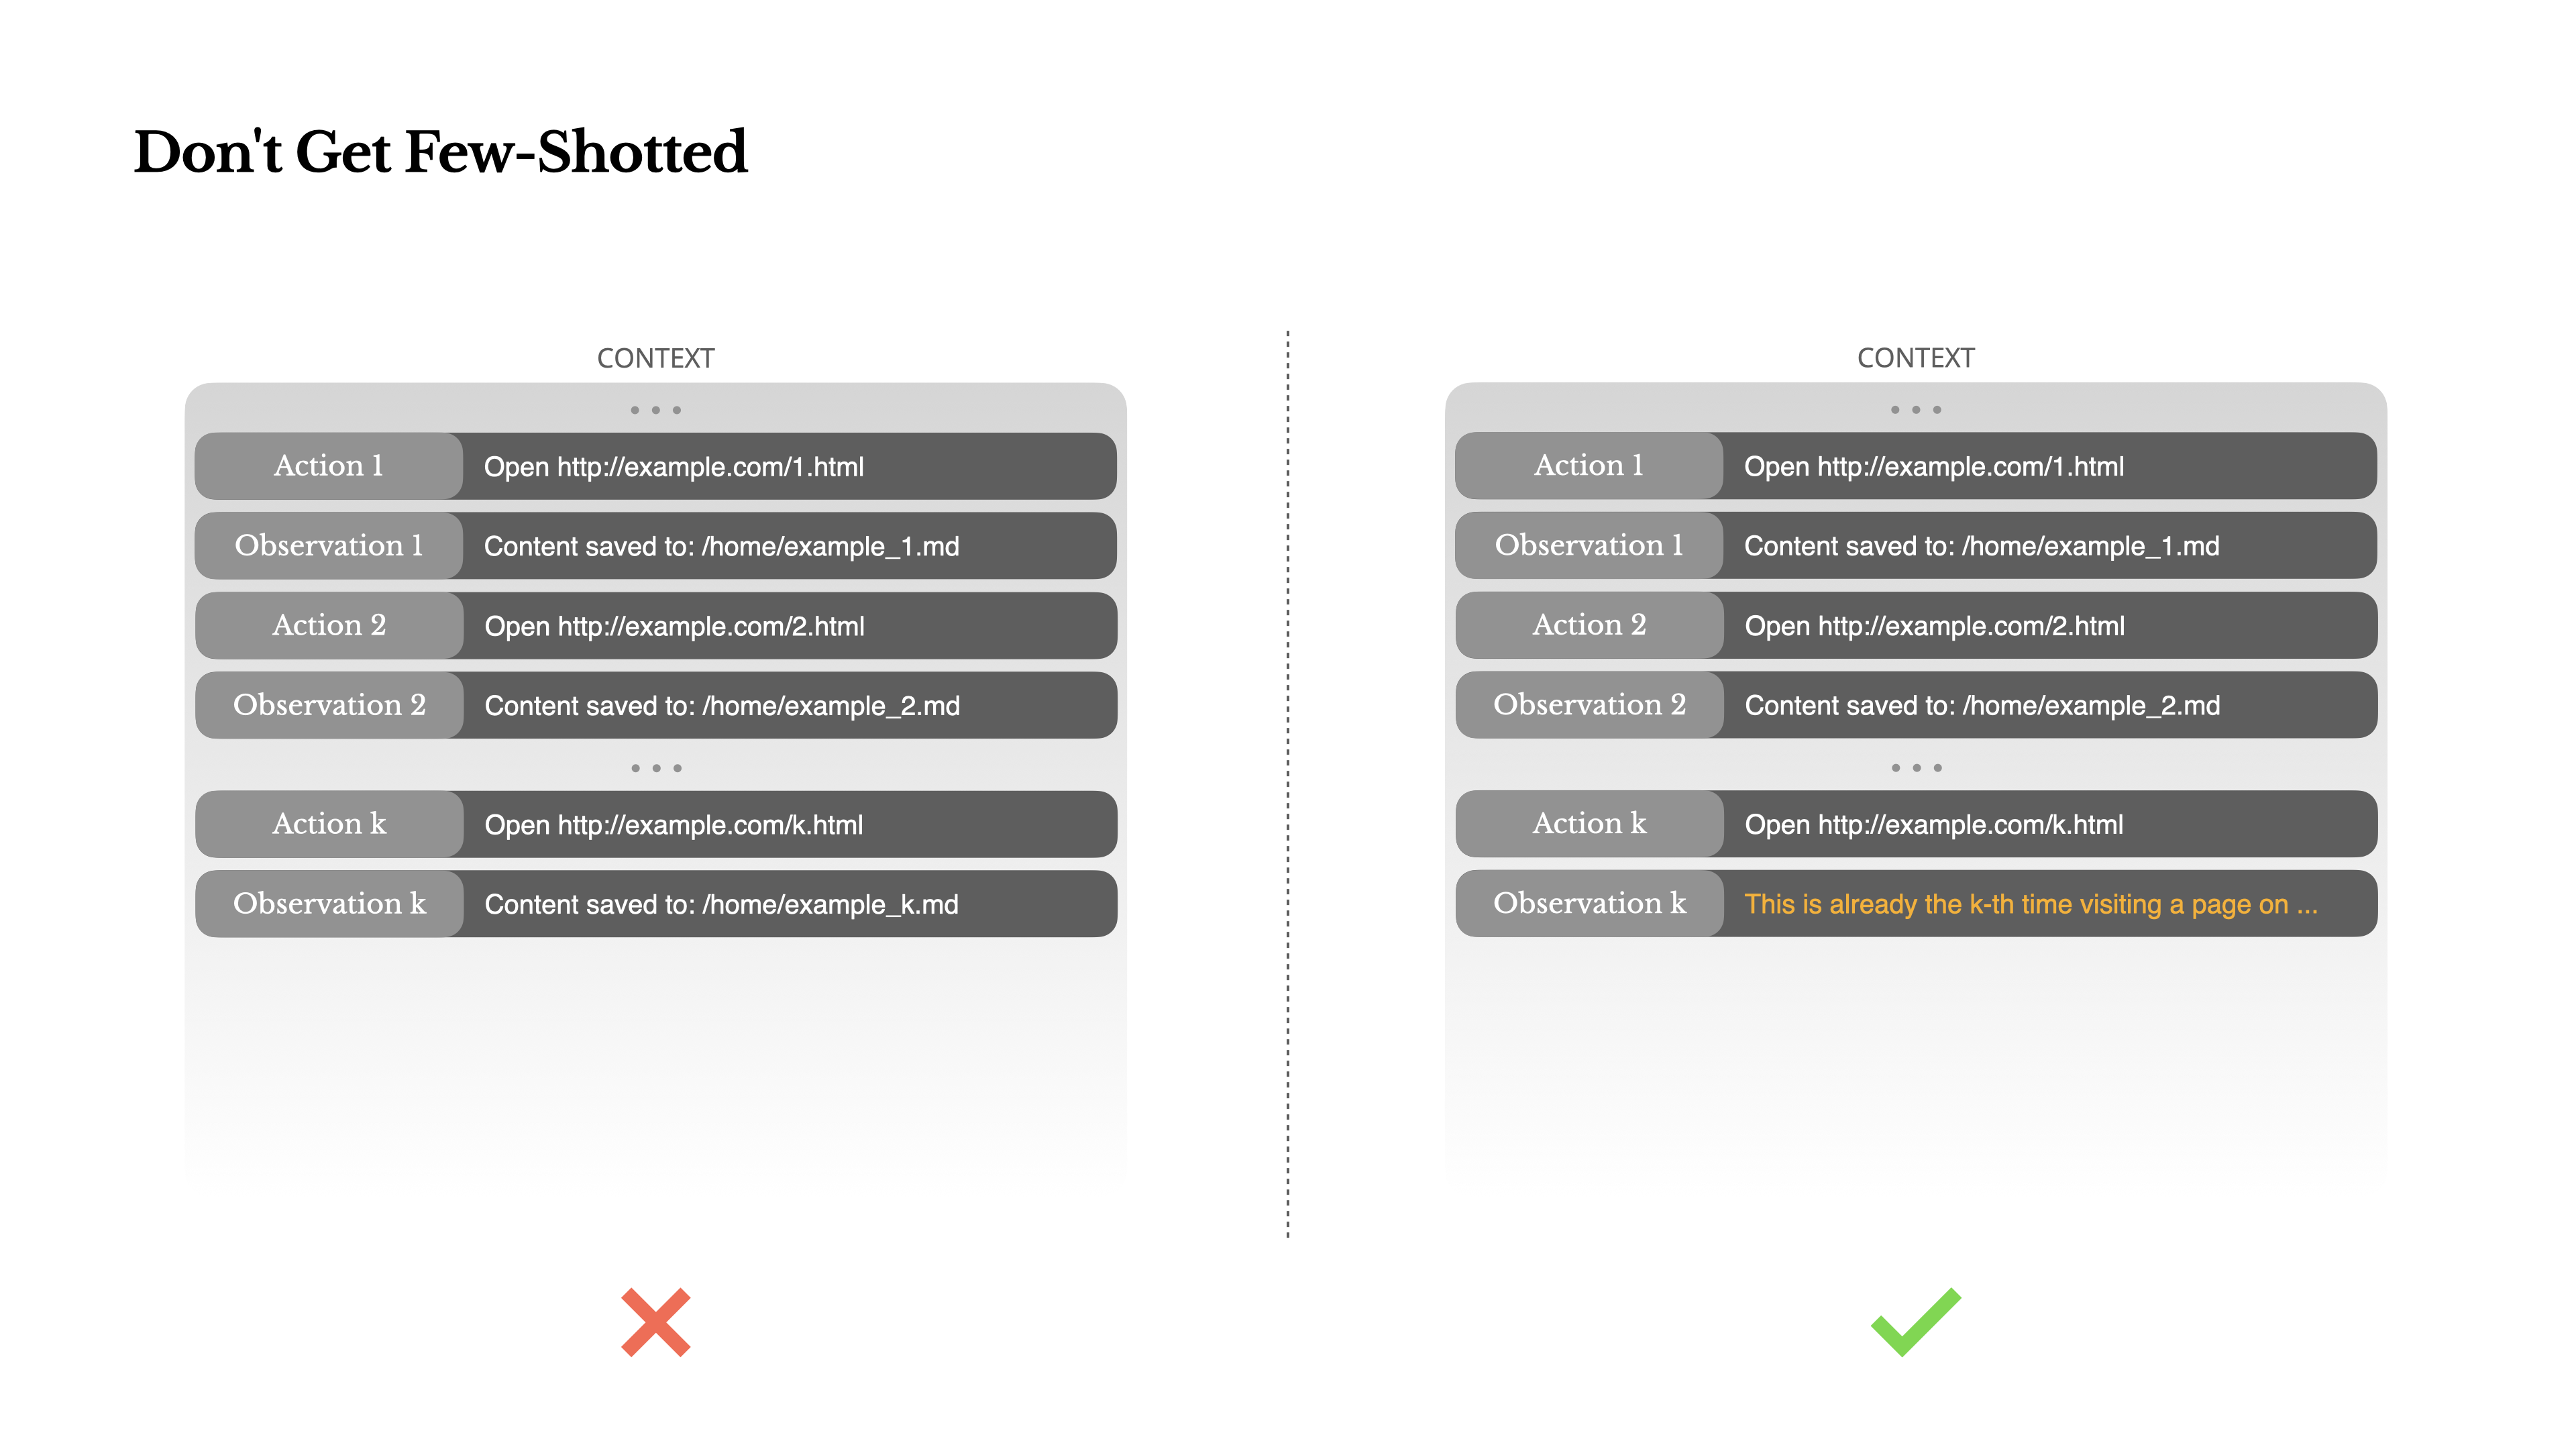
Solusinya adalah meningkatkan keberagaman. Manus memperkenalkan sedikit variasi terstruktur dalam tindakan dan observasi—template serialisasi yang berbeda, frasa alternatif, sedikit noise dalam urutan atau pemformatan. Keacakan terkontrol ini membantu memecah pola dan menyesuaikan perhatian model.
Dengan kata lain, jangan terjebak dalam pola pikir yang sempit karena contoh yang terbatas. Semakin seragam konteks Anda, semakin rapuh agen Anda.
Kesimpulan
Rekayasa konteks masih merupakan ilmu yang berkembang—tetapi untuk sistem agen, ini sudah menjadi hal yang penting. Model mungkin menjadi lebih kuat, lebih cepat, dan lebih murah, tetapi tidak ada jumlah kemampuan mentah yang dapat menggantikan kebutuhan akan memori, lingkungan, dan umpan balik. Bagaimana Anda membentuk konteks pada akhirnya menentukan bagaimana agen Anda berperilaku: seberapa cepat ia berjalan, seberapa baik ia pulih, dan seberapa jauh ia dapat diskalakan.
Di Manus, kami telah mempelajari pelajaran ini melalui penulisan ulang berulang kali, jalan buntu, dan pengujian dunia nyata dengan jutaan pengguna. Tidak ada yang kami bagikan di sini merupakan kebenaran universal—tetapi ini adalah pola yang berhasil untuk kami. Jika ini membantu Anda menghindari bahkan satu iterasi yang menyakitkan, maka posting ini telah berhasil.
Masa depan agentic akan dibangun satu konteks pada satu waktu. Rekayasalah dengan baik.
