Wide Research: Melampaui Jendela Konteks
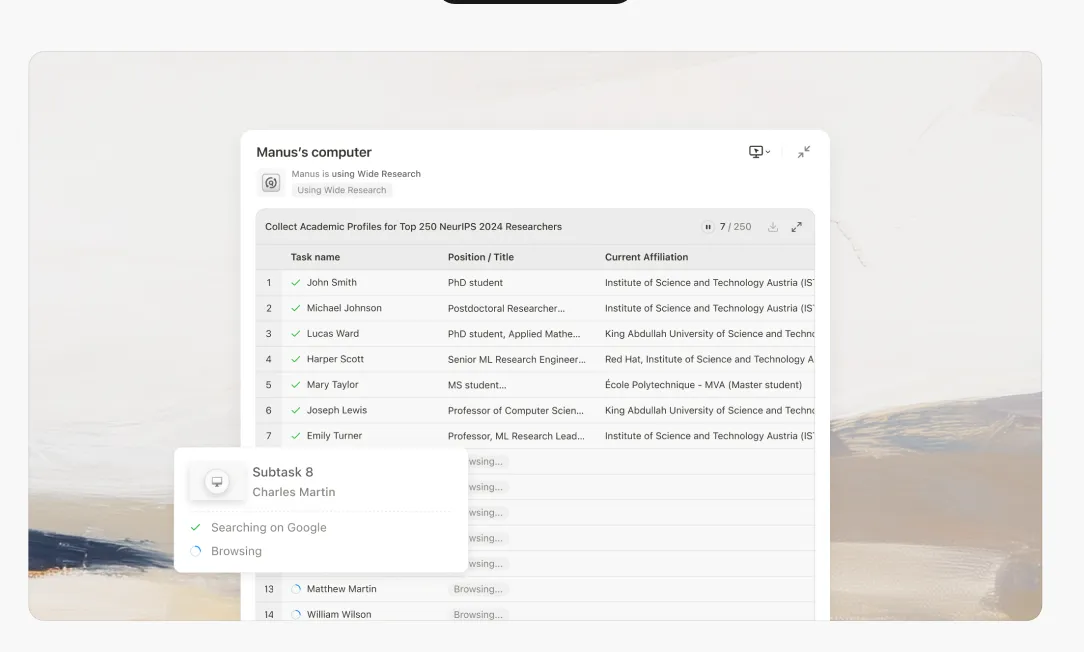
Janji penelitian yang didorong oleh AI selalu menarik: mendelegasikan pekerjaan membosankan pengumpulan dan sintesis informasi ke sistem cerdas, membebaskan kognisi manusia untuk analisis tingkat tinggi dan pengambilan keputusan. Namun, siapa pun yang telah mendorong sistem ini pada kasus penggunaan yang tidak sepele telah menghadapi kenyataan yang membuat frustrasi: pada item kedelapan atau kesembilan dalam tugas penelitian multi-subjek, AI mulai membuat fabrikasi.
Bukan hanya menyederhanakan. Bukan hanya meringkas lebih ringkas. Membuat fabrikasi.
Ini bukan masalah rekayasa prompt. Ini bukan masalah kemampuan model. Ini adalah batasan arsitektur yang diam-diam membatasi utilitas alat penelitian AI sejak awal kemunculannya. Dan ini adalah batasan yang dirancang Wide Research untuk diatasi.
Jendela Konteks: Hambatan Mendasar
Setiap model bahasa besar beroperasi dalam jendela konteks, buffer memori terbatas yang membatasi jumlah informasi yang dapat diproses model secara aktif pada saat tertentu. Model modern telah mendorong batas ini secara mengesankan: dari 4K token hingga 32K, 128K, dan bahkan 1M token dalam versi terbaru.
Namun masalah tetap ada.
Ketika Anda meminta AI untuk meneliti beberapa entitas-misalnya, lima puluh perusahaan, tiga puluh makalah penelitian, atau dua puluh produk yang bersaing-jendela konteks cepat terisi. Bukan hanya informasi mentah tentang setiap entitas, tetapi juga:
•Spesifikasi dan persyaratan tugas asli
•Template struktural untuk format output yang konsisten
•Penalaran dan analisis menengah untuk setiap item
•Referensi silang dan catatan perbandingan
•Konteks kumulatif dari semua item sebelumnya
Pada saat model mencapai item kedelapan atau kesembilan, jendela konteks berada di bawah tekanan yang sangat besar. Model menghadapi pilihan yang tidak mungkin: gagal secara eksplisit, atau mulai memotong sudut.
Ini selalu memilih yang terakhir.
Ambang Batas Fabrikasi
Berikut yang terjadi dalam praktiknya:
Item 1-5: Model melakukan penelitian asli. Ia mengambil informasi, memeriksa silang sumber, dan menghasilkan analisis yang detail dan akurat.
Item 6-8: Kualitas mulai menurun secara halus. Deskripsi menjadi sedikit lebih umum. Model mulai lebih mengandalkan pola sebelumnya daripada penelitian baru.
Item 9+: Model memasuki mode fabrikasi. Tidak mampu mempertahankan beban kognitif penelitian menyeluruh sambil mengelola konteks yang berlebihan, ia mulai menghasilkan konten yang terdengar masuk akal berdasarkan pola statistik, bukan investigasi aktual.
Fabrikasi ini canggih. Mereka terdengar berwibawa. Mereka mengikuti format yang ditetapkan dengan sempurna. Mereka sering kali sempurna secara tata bahasa dan konsisten secara gaya dengan entri awal yang sah.
Mereka juga sering salah.
Analisis pesaing mungkin mengatribusikan fitur kepada perusahaan yang tidak menawarkannya. Tinjauan literatur mungkin mengutip makalah dengan temuan yang dibuat-buat. Perbandingan produk mungkin menciptakan tingkatan harga atau spesifikasi yang tidak ada.
Bagian yang berbahaya adalah bahwa pemalsuan ini sulit dideteksi tanpa verifikasi manual—yang menggagalkan seluruh tujuan dari penelitian otomatis.
Mengapa Jendela Konteks yang Lebih Besar Tidak Dapat Mengatasi Ini
Respons intuitif adalah dengan memperluas jendela konteks. Jika 32K token tidak cukup, gunakan 128K. Jika itu tidak cukup, dorong hingga 200K atau lebih.
Pendekatan ini salah memahami masalahnya.
Pertama, penurunan konteks tidak biner. Model tidak mempertahankan ingatan sempurna di seluruh jendela konteksnya. Studi telah menunjukkan bahwa akurasi pengambilan menurun dengan jarak dari posisi saat ini—fenomena "tersesat di tengah". Informasi di awal dan akhir konteks diingat lebih andal daripada informasi di tengah.
Kedua, biaya pemrosesan meningkat secara tidak proporsional. Biaya untuk memproses konteks 400K token tidak hanya dua kali lipat dari biaya 200K—biaya tersebut meningkat secara eksponensial baik dalam waktu maupun sumber daya komputasi. Ini membuat pemrosesan konteks besar menjadi tidak praktis secara ekonomi untuk banyak kasus penggunaan.
Ketiga, masalahnya adalah beban kognitif. Bahkan dengan konteks yang tidak terbatas, meminta satu model untuk mempertahankan kualitas yang konsisten di seluruh puluhan tugas penelitian independen menciptakan hambatan kognitif. Model harus terus-menerus beralih konteks antar item, mempertahankan kerangka perbandingan, dan memastikan konsistensi gaya—semua itu sambil melakukan tugas penelitian inti.
Keempat, tekanan panjang konteks. "Kesabaran" model, sampai batas tertentu, ditentukan oleh distribusi panjang sampel dalam data pelatihannya. Namun, campuran data pasca-pelatihan dari model bahasa saat ini masih didominasi oleh trajektori yang relatif pendek yang dirancang untuk interaksi gaya chatbot. Akibatnya, ketika panjang konten pesan asisten melebihi ambang batas tertentu, model secara alami mengalami semacam tekanan panjang konteks, mendorongnya untuk bergegas menuju merangkum atau beralih ke bentuk ekspresi yang tidak lengkap seperti poin-poin.
Jendela konteks memang merupakan batasan. Tetapi itu adalah gejala dari keterbatasan arsitektur yang lebih dalam: paradigma sekuensial, prosesor tunggal.
Pergeseran Arsitektur: Pemrosesan Paralel
Wide Research Architecture
Wide Research merepresentasikan pemikiran ulang yang mendasar tentang bagaimana sebuah sistem AI harus menangani tugas penelitian berskala besar. Alih-alih meminta satu prosesor untuk menangani n item secara berurutan, kami mengerahkan n sub-agen paralel untuk memproses n item secara bersamaan.
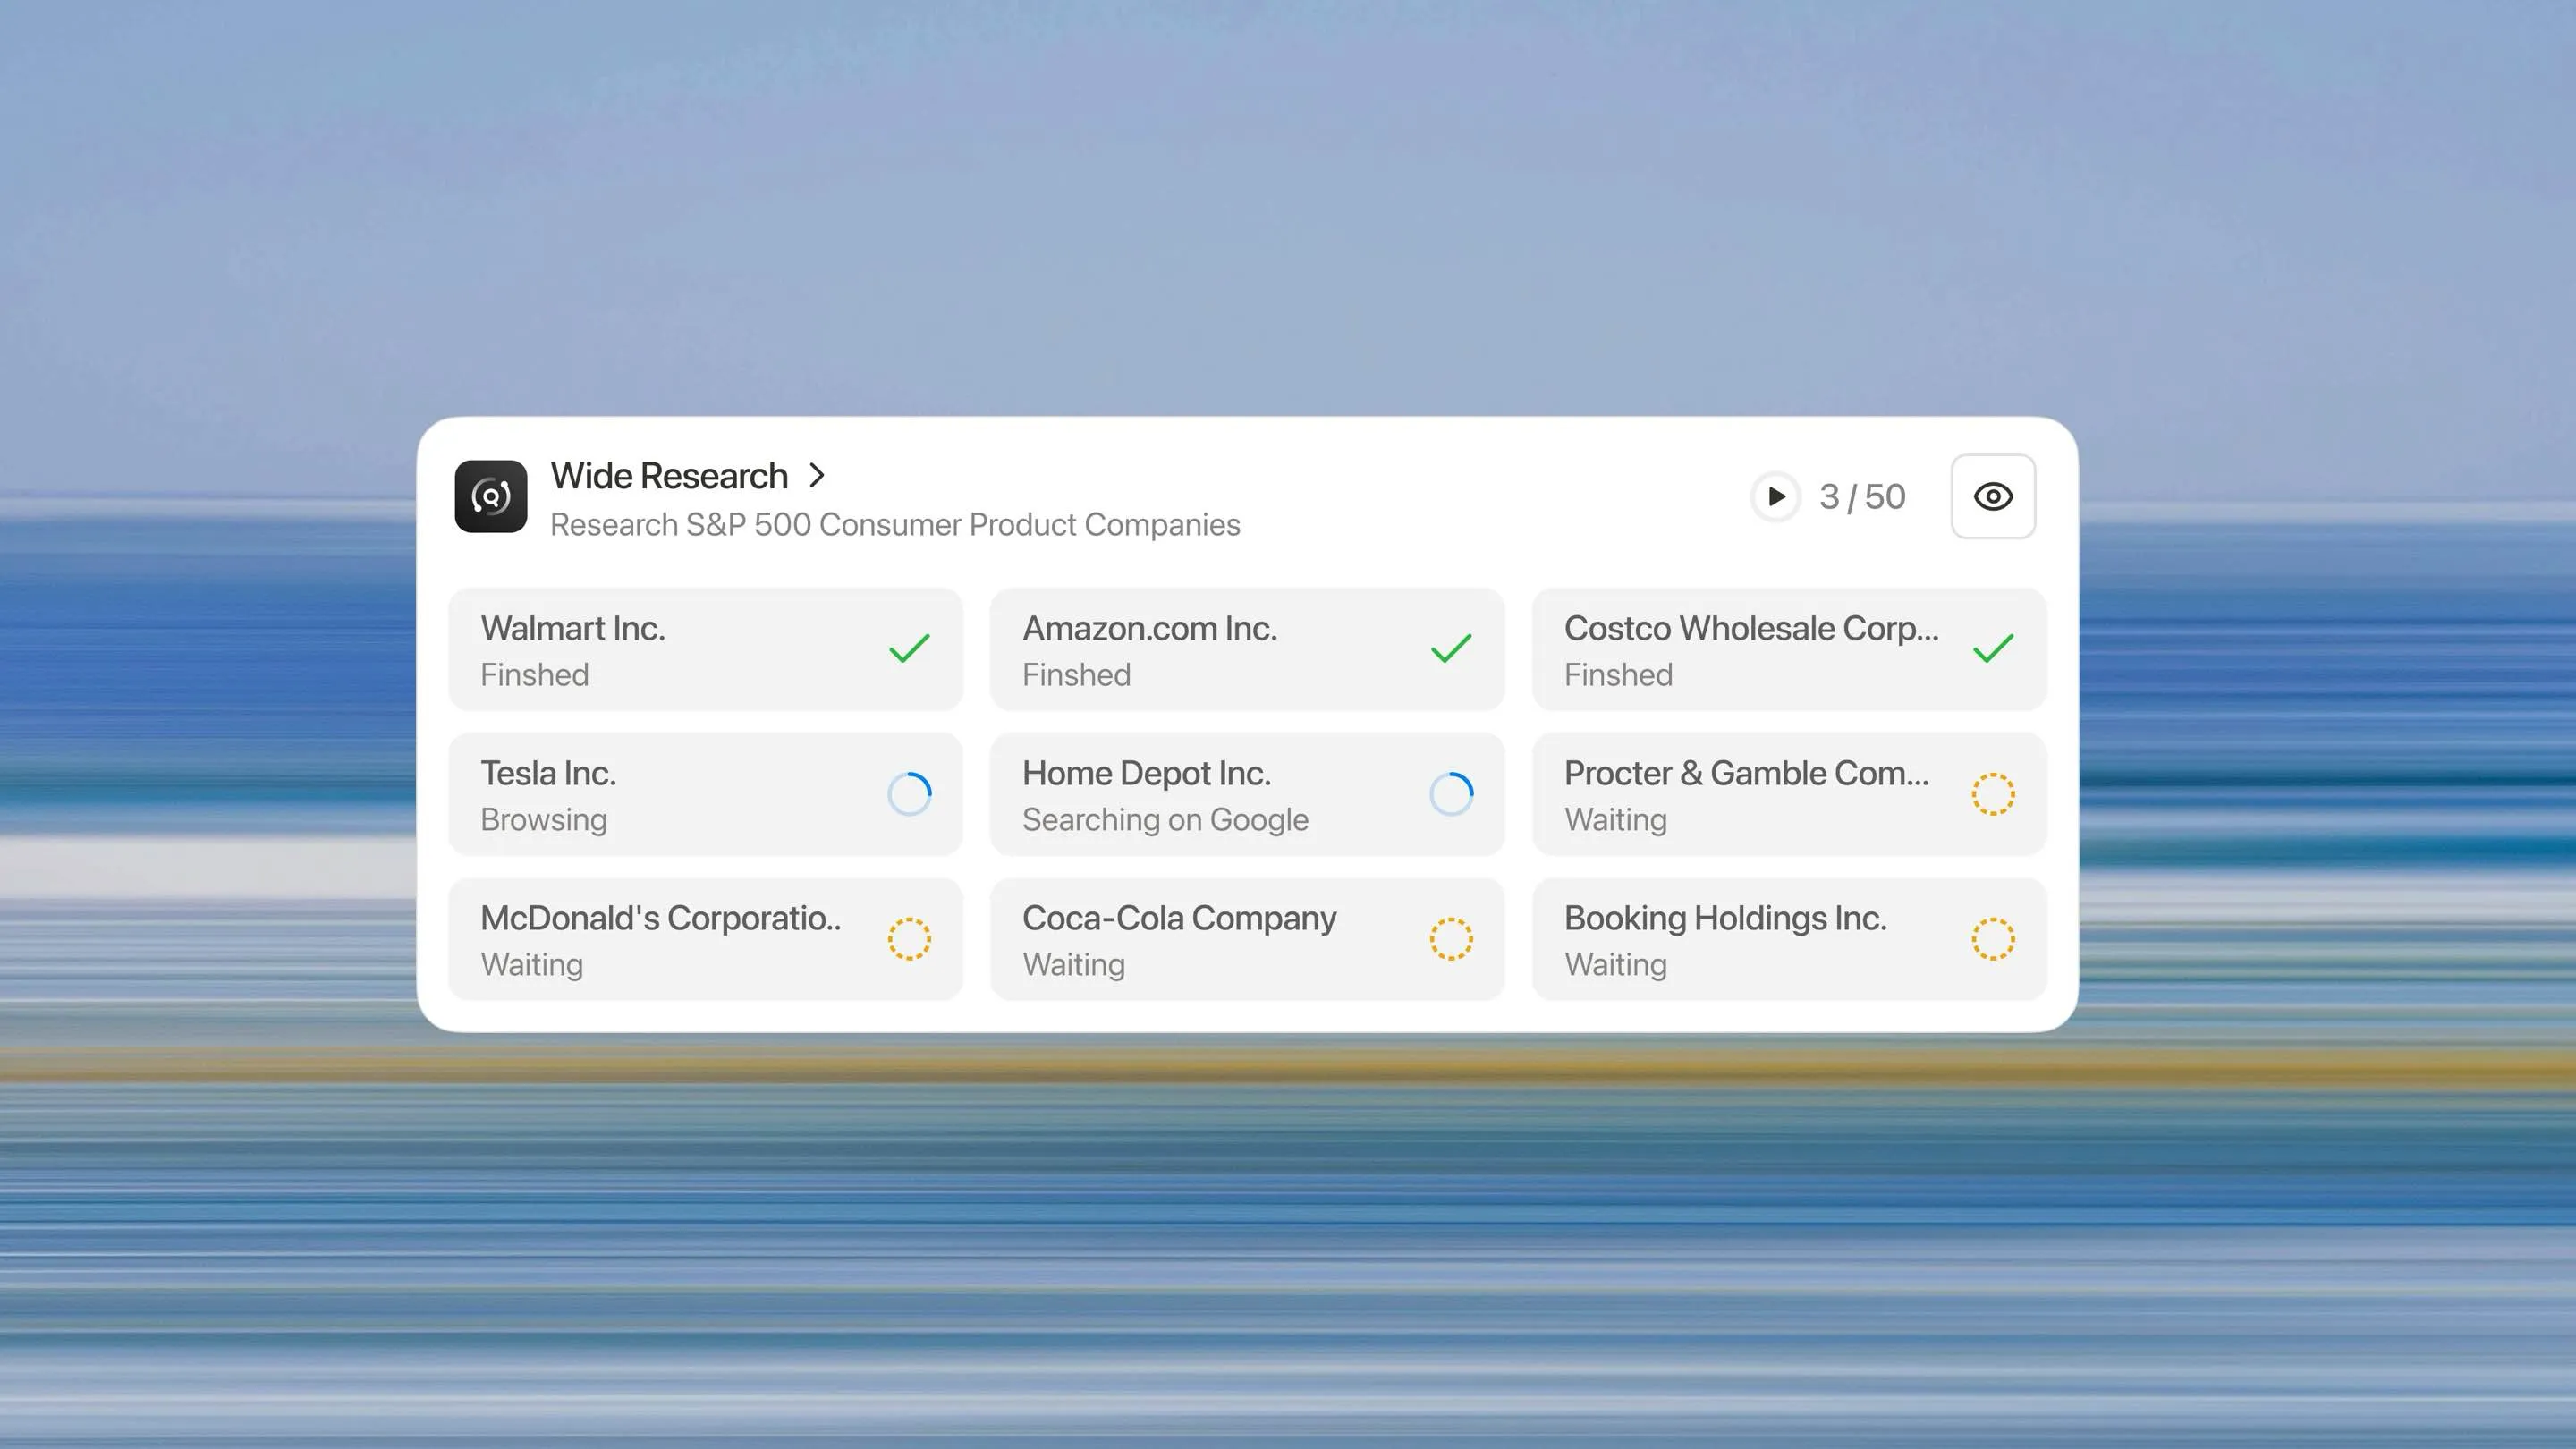
Arsitektur Wide Research
Ketika Anda meluncurkan tugas Wide Research, sistem beroperasi sebagai berikut:
1. Dekomposisi Cerdas
Pengontrol utama menganalisis permintaan Anda dan memecahnya menjadi sub-tugas independen yang dapat diparalelkan. Ini melibatkan pemahaman struktur tugas, identifikasi dependensi, dan pembuatan sub-spesifikasi yang koheren.
2. Delegasi Sub-agen
Untuk setiap sub-tugas, sistem menjalankan sub-agen khusus. Yang penting, ini bukan proses ringan—mereka adalah instance Manus lengkap, masing-masing dengan:
•Lingkungan mesin virtual yang lengkap
•Akses ke seluruh perpustakaan alat (pencarian, browsing, eksekusi kode, penanganan file)
•Koneksi internet independen
•Jendela konteks yang baru dan kosong
3. Eksekusi Paralel
Semua sub-agen berjalan secara bersamaan. Masing-masing berfokus secara eksklusif pada item yang ditugaskan, melakukan kedalaman penelitian dan analisis yang sama seperti yang dilakukan untuk tugas item tunggal.
4. Koordinasi Terpusat
Pengontrol utama mempertahankan pengawasan, mengumpulkan hasil saat sub-agen menyelesaikan pekerjaan mereka. Yang penting, sub-agen tidak berkomunikasi satu sama lain, semua koordinasi mengalir melalui pengontrol utama. Ini mencegah kontaminasi konteks dan mempertahankan independensi.
5. Sintesis dan Integrasi
Setelah semua sub-agen melaporkan kembali, pengontrol utama mensintesis hasil menjadi laporan tunggal yang koheren dan komprehensif. Langkah sintesis ini memanfaatkan kapasitas konteks penuh dari pengontrol utama, karena tidak dibebani dengan upaya penelitian awal.
Mengapa Ini Mengubah Segalanya
Kualitas Konsisten dalam Skala Besar
Setiap item mendapatkan perlakuan yang sama. Item ke-50 diteliti sama menyeluruhnya seperti yang pertama. Tidak ada kurva degradasi, tidak ada ambang fabrikasi, dan tidak ada penurunan kualitas.
Skalabilitas Horizontal Sejati
Perlu menganalisis 10 item? Sistem mengerahkan 10 sub-agen. Perlu menganalisis 500? Sistem mengerahkan 500. Arsitektur ini menskalakan secara linier dengan ukuran tugas, tidak secara eksponensial seperti pendekatan berbasis konteks.
Peningkatan Kecepatan yang Signifikan
Karena sub-agen beroperasi secara paralel, waktu dunia nyata yang diperlukan untuk menganalisis 50 item kurang lebih sama dengan waktu untuk menganalisis 5. Hambatan beralih dari waktu pemrosesan sekuensial ke waktu sintesis—komponen yang jauh lebih kecil dari keseluruhan tugas.
Tingkat Halusinasi yang Berkurang
Independensi dan Keandalan
Karena sub-agen tidak berbagi konteks, kesalahan atau halusinasi dalam pekerjaan satu sub-agen tidak menyebar ke yang lain. Setiap analisis berdiri sendiri, mengurangi risiko sistemik.
Melampaui Paradigma Prosesor Tunggal
Wide Research lebih dari sekadar fitur—ini merepresentasikan pergeseran fundamental dari paradigma prosesor tunggal menuju arsitektur paralel yang terkoordinasi. Masa depan sistem AI tidak terletak pada jendela konteks yang semakin besar, tetapi pada dekomposisi tugas yang cerdas dan eksekusi paralel.
Kita sedang bergerak dari era "AI asisten" menuju era "tenaga kerja AI."
Kapan menggunakan Wide Research: Tugas apa pun yang melibatkan beberapa item serupa yang memerlukan analisis konsisten—riset kompetitif, tinjauan literatur, pemrosesan massal, pembuatan multi-aset.
Kapan tidak menggunakan: Tugas yang sangat berurutan di mana setiap langkah sangat bergantung pada hasil sebelumnya, atau tugas kecil (kurang dari 10 item) di mana penanganan prosesor tunggal lebih hemat biaya.
Wide Research tersedia untuk semua pelanggan
Lompatan arsitektur dari satu asisten AI ke tenaga kerja terkoordinasi dari sub-agen kini tersedia untuk semua pelanggan. Ini adalah paradigma baru untuk penelitian dan analisis yang didukung AI.
Kami mengundang Anda untuk mengalami perbedaannya secara langsung. Bawa tantangan penelitian skala besar Anda—yang menurut Anda tidak mungkin dilakukan oleh AI—dan saksikan bagaimana pendekatan pemrosesan paralel memberikan hasil yang konsisten dan berkualitas tinggi dalam skala besar.
Era tenaga kerja AI telah tiba. Mulai tugas Wide Research Anda hari ini.
 Coba Manus Wide Research di Manus Pro →
